Tot vorbeam intr-un articol precedent despre Wii de la Nintendo. V-ati gandi ca e o jucarie inofensiva, care ocazional te poate face sa arati ridicol? V-ati inselat in legatura cu prima parte!
Poate-l ajuta Mama cumva...
joi, 15 ianuarie 2009

marți, 13 ianuarie 2009
Uber Interfete!

Folosind ultimele cercetari in neuro-tehnologie, Emotiv Systems au dezvoltat o casca revolutionara, in scopul interactiunii intre om si calculator. Avatarurile prind astfel viata, folosind expresii faciale in timp real, interactioneaza cu continuturi ce raspund emotiilor tale si controleaza obiecte cu puterea mintii!
Emotiv este compania care a aruncat pe piata interfetele om-masina ale viitorului. E ca si cum iei tot ce stim pana acum despre interfete, il lustruiesti si obtii ceva cu totul si cu totul nou, ale carui noi posibilitati ti se par infinite.

Cei de la Emotiv s-au gandit sa proiecteze o serie de interfete om-masina care sa faca adauge la caracterul voluntar al comunicarii dintre cele doua entitati si dimensiunea inconstienta a acesteia. Solutiile EPOC sau EmoKey sunt emblema companiei orientata in acest moment catre industria jocurilor video, dar al carei scop declarat, pentru viitor, este acela de a oferi solutii in domenii industriale cat mai diverse.
Aruncati o privire si in ograda celor de la Emotiv Systems!
A doua viata!
O parere neavizata despre interfete om masina...
De la Nintendo Wii si SecondLife la Sinulator sau Emily! Intram intr-o alta lume (virtuala?!) sau exploram o realitate necunoscuta pana acum?
De la Nintendo Wii si SecondLife la Sinulator sau Emily! Intram intr-o alta lume (virtuala?!) sau exploram o realitate necunoscuta pana acum?
Introducere in tehnologii XML -- Part 2 -- SAX
SAX (Simple API for XML) este un parsre cu acces serial pentru XML ,oferind un mecanism de citire al datelor dintr-un fiser de tip XML.
Orice parser care implementeaza SAX va fi un parser de stream condus de evenimente. Asta se traduce liber in faptul ca in momentul in care parsarea va detecta un anumit eveniment (inceput de fisier ,inceput de tag ,sfarsit de fiseri ,etc) se va declansa un trigger care va apela o metoda definita de user ,astfel reusindu-se sa se extraga informatii din fiser.
Parser-ul SAX are doua avantaje majore asupra DOM - ului : este mai rapid si foloseste mai putina memorie. Totusi ,SAX este destul de dificil de folosit cand avem fisiere XML de stul de complicate ,uesr-ul putand gresi cand defineste metodele ce se declanseaza la diferite tipuri de evenimente.
De exemplu ,avand urmatorul XML
<rootelement param="value"> <firstelement> Some Text </firstelement> <secondelement param2="something"> Pre-Text <inline>Inlined text</inline> Post-text. </secondelement> </rootelement>
Parserul XML va genera o secventa de evenimente similare cu:
Orice parser care implementeaza SAX va fi un parser de stream condus de evenimente. Asta se traduce liber in faptul ca in momentul in care parsarea va detecta un anumit eveniment (inceput de fisier ,inceput de tag ,sfarsit de fiseri ,etc) se va declansa un trigger care va apela o metoda definita de user ,astfel reusindu-se sa se extraga informatii din fiser.
Parser-ul SAX are doua avantaje majore asupra DOM - ului : este mai rapid si foloseste mai putina memorie. Totusi ,SAX este destul de dificil de folosit cand avem fisiere XML de stul de complicate ,uesr-ul putand gresi cand defineste metodele ce se declanseaza la diferite tipuri de evenimente.
De exemplu ,avand urmatorul XML
<rootelement param="value"> <firstelement> Some Text </firstelement> <secondelement param2="something"> Pre-Text <inline>Inlined text</inline> Post-text. </secondelement> </rootelement>
Parserul XML va genera o secventa de evenimente similare cu:
- XML Processing Instruction,numita xml, cu atributele version egal cu "1.0" si encoding egfal cu "UTF-8"
- XML Element start, numit RootElement, cu un atribut param egal cu "value"
- XML Element start, numit FirstElement
- XML Text node, cu data "Some Text"
- XML Element end, numit FirstElement
- XML Element start, numit SecondElement, cu un atribut param2 egal cu "something"
- XML Text node, cu data "Pre-Text"
- XML Element start, numit Inline
- XML Text node, cu data "Inlined text"
- XML Element end, numit Inline
- XML Text node,cu data "Post-text."
- XML Element end, numit SecondElement
- XML Element end, numit RootElement
XML: Atribute versus Elemente
Lucrand la cel mai recent produs al nostru, un parser de arhive pentru diverse aplicatii de tip instant messenger, una din sarcinile pe care le-am avut de indeplinit a fost aceea de a construi o serie de fisiere XML, prin intermediul carora sa modelez informatia legata de tot ceea ce insemna o arhiva specifica unei astfel de aplicatii:
<?xml version="1.0" encoding="UTF-8" ?>
<log>
<auth>
<username value="user1">
<password value="pass1"/>
</auth>
Intrebare fireasca in aceasta situatie: user1 este valoare a elementului
Raspunsuri variate. Sigur este ca nu exista nici o regula, nici un standard in ceea ce priveste aceasta alegere.
Un articol interesant, scris de Uche Ogbuji, de la IBM, mi-a atras atentia. Acesta propune un set de 4 reguli pentru rezolvarea acestei dileme:
· daca informatia poate fi marcata ea insasi cu elemente, atunci devine element.
· daca este mai bine ca informatia sa devina atribut, dar exista posibilitatea ca elementul in cauza sa primeasca si alte atribute, atunci se recomanda folosirea unui nou etaj, de copii, informatiile devenind valori ale elementelor.
· daca informatia trebuie sa se incadreze intr-un standard asemanator DTD, acesta cerand atribute specifice (ID, IDREF, ENTITY), se foloseste un atribut.
· daca informatia nu trebuie normalizata, in vederea caracterelor whitespace, se folosesc elementele.
Cum bine remarca autorul articolului referit, lucrurile nu sunt atat de clare cand vine vorba de identificarea cazului in care te afli la un moment dat. Lasam asadar regulile la o parte si incercam cateva „sugestii”.
In primul rand, din categoria asa-NU:
· „faceti totul un element”: argumentele folosite pentru a sprijini aceasta idee variaza de la „Atributele complica lucrurile” pana la „Atributele inhiba extensibilitatea”. Totusi, nefolosirea atributelor, anuleaza unul dintre cele mai importante aspecte ale XML-ului.
· „daca este genul de continut ce trebuie afisat in browser, folositi valoarea unui element”. Problema cu aceasta sugestie este faptul ca incurajeaza utilizatorii sa gandeasca design-ul de continut al XML in termeni de prezentare, doua aspecte care este important sa nu fie amestecate.
Intr-un articol viitor, vom reveni si cu sugestiile de tip asa-DA.
Surse:
http://www.ibm.com/developerworks/xml/library/x-eleatt.html
http://xmleverywhere.com/newsletters/20000525.htm
Introducere in tehnologii XML -- Part 1 -- DOM
DOM este un standard World Wide Web Consortium pentru accesarea documentelor XML sau XHTML.
Din punc de vedere structural DOM - ul se imparte in trei niveluri :
De exemplu pentru urmatorul XML ,DOM-ul asociat ca avea structura:
Proprietati DOM
Metodele utilizate in DOM
Din punc de vedere structural DOM - ul se imparte in trei niveluri :
- Core DOM - modelul standard pentru orice fel de document structurat
- XML DOM - modelul standard pentru fisere XML + obiecte si propietati ale elemetelor documentului
- HTML DOM - modelul standard pentru fisere HTML + obiecte si propietati ale elemetelor documentului
- Intregul document este un nod de tip document
- Oricare element XML este un nod de tip element
- Textul dintr-un fisier XML este un nod de tip text
- Oricare atribut XML este un nod de tip atribut
De exemplu pentru urmatorul XML ,DOM-ul asociat ca avea structura:
<?xml version="1.0" encoding="ISO-8859-1"?>
<bookstore>
<book category="cooking">
<title lang="en">Everyday Italian</title>
<author>Giada De Laurentiis</author>
<year>2005</year>
<price>30.00</price>
</book>
<book category="children">
<title lang="en">Harry Potter</title>
<author>J K. Rowling</author>
<year>2005</year>
<price>29.99</price>
</book>
<book category="web">
<title lang="en">XQuery Kick Start</title>
<author>James McGovern</author>
<author>Per Bothner</author>
<author>Kurt Cagle</author>
<author>James Linn</author>
<author>Vaidyanathan Nagarajan</author>
<year>2003</year>
<price>49.99</price>
</book>
<book category="web" cover="paperback">
<title lang="en">Learning XML</title>
<author>Erik T. Ray</author>
<year>2003</year>
<price>39.95</price>
</book>
</bookstore>

Proprietati DOM
- x.nodeName - numele lui x
- x.nodeValue - valoarea lui x
- x.parentNode -nodul parinte al lui x
- x.childNodes - nodurile copii ale lui x
- x.attributes - nodurile atribut ale lui x
Metodele utilizate in DOM
- x.getElementsByTagName(name) - extrage un element cu numele "name"
- x.appendChild(node) - se insereaza un nod copil sub nodul x
- x.removeChild(node) - se sterge un copil din nodul x
Securitate site ReCaptcha
Zilele trecute am primit sarcina de a face o mica aplicatie care sa stopeze spamul nedorit facut de roboti automati pe un site (nu dau nume sa nu fac publicitate).
Dupa o studiere mai atenta a problemei ,am ajuns la solutie : CAPTCHA ,in traducere libera "Completely Automated Public Turing test to tell Computers and Humans Apart".Si da ,aceasta este baza imaginilor enervante care contin text si care trebuiesc studiate cand vrei sa te inscrii undeva sau sa postezi vreun comentariu.

Mai multe detalii depsre subiectul de baza CAPTCHA la http://en.wikipedia.org/wiki/CAPTCHA
Continuand cautarile am gasit o librarie gratuita pe www.recaptca.net ,tot ce trebuie sa faci este sa iti creezi un cont gratuit si sa obtii doua chei : una publica si una secreta pentru domeniul tau.
Am gasit pe code.google.com si libraria in java pentru aplicatie ,iar restul implementarii a fost floare la ureche.
Daca vreodata aveti nevoie de o asemenea aplicatie pentrul site-ul vostru ,va recomand ReCaptcha ,aceasta fiind bine documentata si foarte usor de implementat.
Dupa o studiere mai atenta a problemei ,am ajuns la solutie : CAPTCHA ,in traducere libera "Completely Automated Public Turing test to tell Computers and Humans Apart".Si da ,aceasta este baza imaginilor enervante care contin text si care trebuiesc studiate cand vrei sa te inscrii undeva sau sa postezi vreun comentariu.
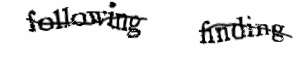
Mai multe detalii depsre subiectul de baza CAPTCHA la http://en.wikipedia.org/wiki/CAPTCHA
Continuand cautarile am gasit o librarie gratuita pe www.recaptca.net ,tot ce trebuie sa faci este sa iti creezi un cont gratuit si sa obtii doua chei : una publica si una secreta pentru domeniul tau.
Am gasit pe code.google.com si libraria in java pentru aplicatie ,iar restul implementarii a fost floare la ureche.
Daca vreodata aveti nevoie de o asemenea aplicatie pentrul site-ul vostru ,va recomand ReCaptcha ,aceasta fiind bine documentata si foarte usor de implementat.
luni, 15 decembrie 2008
Highlight-uri
Am postat doua variante de highlight. Una foloseste javascript, cealalta foloseste exclusiv PHP. Le puteti testa aici In curand le vom detalia si veti putea accesa codurile sursa si pe site-urile noastre.
vineri, 5 decembrie 2008
Primii si cu site-ul secundar
luni, 1 decembrie 2008
Suntem pe prima pagina
Pe google, la cautarea interfete evoluate. Faceti acum print screen-urile, ca nu se stie.
Tema 3, Javascript si Ajax
A fost postata tema 3. Deadline 16 decembrie. Si enuntul....
Search cu highlight pe text
Se cere sa se realizeze un script care sa extraga termeni de cautare dintr-o pagina HTML si sa ii marcheze vizual (similar cu functionalitatea google http://www.googleguide.com/favorite_highlighting.html
- versiune simplificata, fara highlight diferentiat ca si culoare pe fiecare cuvant in cazul in care sunt mai multe cuvinte folosite ca termeni de cautare)
In acest scop, se va folosi o pagina HTML cu un formular in care se vor introduce termenii de cautare si numele fisierului HTML in care se va efectua cautarea (alt fisier HTML pe acelasi server). La apasarea unui buton de search, se afiseaza in aceeasi pagina cu formularul, intregul text din fisierul selectat anterior avand termenii de cautare highlighted.
Formularul va ramane vizibil, permitand o noua cautare.
Se vor trimite : fisierele HTML (atat cel care contine formularul de cautare cat si cele folosite pentru textul pe care se face search) si fisierele Javascript folosite.
Folosirea AJAX nu este obligatorie dar se va acorda un bonus de 10% pentru cei care folosesc.
Search cu highlight pe text
Se cere sa se realizeze un script care sa extraga termeni de cautare dintr-o pagina HTML si sa ii marcheze vizual (similar cu functionalitatea google http://www.googleguide.com/favorite_highlighting.html
- versiune simplificata, fara highlight diferentiat ca si culoare pe fiecare cuvant in cazul in care sunt mai multe cuvinte folosite ca termeni de cautare)
In acest scop, se va folosi o pagina HTML cu un formular in care se vor introduce termenii de cautare si numele fisierului HTML in care se va efectua cautarea (alt fisier HTML pe acelasi server). La apasarea unui buton de search, se afiseaza in aceeasi pagina cu formularul, intregul text din fisierul selectat anterior avand termenii de cautare highlighted.
Formularul va ramane vizibil, permitand o noua cautare.
Se vor trimite : fisierele HTML (atat cel care contine formularul de cautare cat si cele folosite pentru textul pe care se face search) si fisierele Javascript folosite.
Folosirea AJAX nu este obligatorie dar se va acorda un bonus de 10% pentru cei care folosesc.
duminică, 30 noiembrie 2008
Votul la romani
PSD-PC iar sunt in postura de castigatori-invinsi. PD-L si PNL au impreuna mai mult de 50%. Si, partea buna a situatie, PRM si PNG sunt istorie.
PSD-ul e pe locul doi, la ora 10, dupa numararea a 74% din voturi. E cineva mai penibil decat Geoana in situatia asta?
PSD-ul e pe locul doi, la ora 10, dupa numararea a 74% din voturi. E cineva mai penibil decat Geoana in situatia asta?
sâmbătă, 29 noiembrie 2008
Interfetele si vremurile
Gmail promoveaza o noua (cel putin asa stiu eu) interfata pentru conturile sale de email. Interfata Tree se actualizeaza in functie de starea vremii pentru locatia setata de utilizator. Cum multi ajung sa vada un monitor mai des decat o fereastra...
Si tot in aceeasi categorie, o aplicatie interesanta este EarthDesk, un program care iti inlocuieste imaginea de pe desktop cu o imagine dinamica a planetei, updatata in timp real, cu formatiunile noroase, cu luminile oraselor, cu tot felul de aspecte realiste care pot fi setate de utilizator.
Site-ul nostru oficial de interfete evoluate este http://interfete.eu
Si tot in aceeasi categorie, o aplicatie interesanta este EarthDesk, un program care iti inlocuieste imaginea de pe desktop cu o imagine dinamica a planetei, updatata in timp real, cu formatiunile noroase, cu luminile oraselor, cu tot felul de aspecte realiste care pot fi setate de utilizator.
Site-ul nostru oficial de interfete evoluate este http://interfete.eu
Ce face un bilet gratis din studenti?
Dornici de duca...ar putea fi raspunsul. Am zice ca in weekend-ul acesta au ramas campusurile goale ca urmare a masurii guvernului de a acorda bilete gratuite de tren studentilor, pentru ca acestia sa fie buni cetateni si sa mearga la vot, acasa. Spiritul civic al tinerilor patriei s-a dezghetat si garile au fost luate cu asalt. O adevarata provocare...votul. Mai multe informatii si imagini aici
Grid-ul, reteaua viitorului
Pentru mulţi, internetul a devenit un standard maximal atunci când vine vorba de a pune în comun resurse şi informaţii din toate colţurile lumii. Dar asta nu e totul atunci când vine vorba de reţele de computere. Unul dintre proiectele de viitor este acela care implică resursele unui calculator şi atunci când el nu este folosit de posesor.
Este vorba de World Wide Grid, un concept aflat acum în stadiul în care World Wide Web-ul era spre sfârşitul anilor ’80, adică un proiect conturat în special în mediul academic şi ştiinţific. Grid-ul este o hiperreţea în care calculatoarele îşi pun în comun puterea de procesare, capacitatea de stocare şi, în general, toate caracteristicile de care dispun. Simplist vorbind, este ca şi când un singur calculator beneficiează de performanţele cumulate ale tuturor sistemelor de calcul înscrise în reţea. În prezent există mai multe astfel de reţele concepute pentru a servi diverse scopuri ştiinţifice sau educaţionale.
MODELE
Una dintre cele mai ample infrastructuri multidisciplinare de tip “grid” poartă numele de EGEE (Enabling Grids for E-Science), în care sunt implicate peste 140 de instituţii, având locaţii în peste 50 de state. Circa 10.000 de utilizatori au prin intermediul EGEE acces la puterea de procesare a 80.000 de procesoare.
De o recentă popularizare s-a bucurat o altă reţea de acest tip, WorldWide LHC Computing Grid, care va fi folosită pentru procesarea uriaşului volum de date rezultate în urma experimentului realizat de CERN (Organizaţia Europeană pentru Cercetare Nucleară). 140 de centre de calculatoare, cumulând circa 100.000 de procesoare, sunt pregătite pentru a lucra împreună la procesarea celor 15 milioane de GB de informaţii pe an estimate a fi rezultate în urma celui mai amplu experiment din istoria omenirii. Mai nou, WorldWide LHC Computing Grid este utilizată de două companii care lucrează la implementarea motorului de căutare al viitorului, potrivit publictechnology.net. Imense Ltd şi iLexIR Ltd folosesc infrastructura acestui grid pentru a-şi testa şi îmbunătăţi programele specializate în procesarea limbajului natural şi în returnarea unor rezultate relevante în materie de căutări online de imagini şi conţinut video.
ACCESIBILITATE
Principala barieră în creşterea popularităţii concept de grid şi implicit în folosirea acestui tip de arhitectură pe scară largă o constituie faptul că aceste reţele sunt destul de greu de utilizat, fiind necesare cunoştinţe de specialitate şi abilităţi de programator. Facilitarea accesului la astfel de grid-uri este deci una dintre principalele preocupări ale cercetătorilor din domeniu. Un pas în acest sens a fost făcut prin intermediul proiectului european g-Eclipse, în cadrul căruia a fost concepută o interfaţă grafică uşor de folosit, similară cu cea utilizată în cazul sistemului de operare Windows, care permite accesarea resurselor unei reţele de acest tip prin numai câteva butonări ale mouse-ului. O altă problemă de accesibilitate ar fi dată de faptul că în prezent există mai multe tipuri de arhitecturi utilizate în realizarea acestor reţele, fiind necesar un mecanism care să depăşească această barieră atunci când vine vorba de acordarea unui acces facil la resursele unui grid. Indiferent de structura pe care acesta o prezintă, g-Eclipse oferă o soluţie în acest sens, fiind conceput ca un echivalent al browsere-lor actuale pentru ceea ce ar putea deveni World Wide Grid.
Sursa Jurnalul National, Mihai Manole
Este vorba de World Wide Grid, un concept aflat acum în stadiul în care World Wide Web-ul era spre sfârşitul anilor ’80, adică un proiect conturat în special în mediul academic şi ştiinţific. Grid-ul este o hiperreţea în care calculatoarele îşi pun în comun puterea de procesare, capacitatea de stocare şi, în general, toate caracteristicile de care dispun. Simplist vorbind, este ca şi când un singur calculator beneficiează de performanţele cumulate ale tuturor sistemelor de calcul înscrise în reţea. În prezent există mai multe astfel de reţele concepute pentru a servi diverse scopuri ştiinţifice sau educaţionale.
MODELE
Una dintre cele mai ample infrastructuri multidisciplinare de tip “grid” poartă numele de EGEE (Enabling Grids for E-Science), în care sunt implicate peste 140 de instituţii, având locaţii în peste 50 de state. Circa 10.000 de utilizatori au prin intermediul EGEE acces la puterea de procesare a 80.000 de procesoare.
De o recentă popularizare s-a bucurat o altă reţea de acest tip, WorldWide LHC Computing Grid, care va fi folosită pentru procesarea uriaşului volum de date rezultate în urma experimentului realizat de CERN (Organizaţia Europeană pentru Cercetare Nucleară). 140 de centre de calculatoare, cumulând circa 100.000 de procesoare, sunt pregătite pentru a lucra împreună la procesarea celor 15 milioane de GB de informaţii pe an estimate a fi rezultate în urma celui mai amplu experiment din istoria omenirii. Mai nou, WorldWide LHC Computing Grid este utilizată de două companii care lucrează la implementarea motorului de căutare al viitorului, potrivit publictechnology.net. Imense Ltd şi iLexIR Ltd folosesc infrastructura acestui grid pentru a-şi testa şi îmbunătăţi programele specializate în procesarea limbajului natural şi în returnarea unor rezultate relevante în materie de căutări online de imagini şi conţinut video.
ACCESIBILITATE
Principala barieră în creşterea popularităţii concept de grid şi implicit în folosirea acestui tip de arhitectură pe scară largă o constituie faptul că aceste reţele sunt destul de greu de utilizat, fiind necesare cunoştinţe de specialitate şi abilităţi de programator. Facilitarea accesului la astfel de grid-uri este deci una dintre principalele preocupări ale cercetătorilor din domeniu. Un pas în acest sens a fost făcut prin intermediul proiectului european g-Eclipse, în cadrul căruia a fost concepută o interfaţă grafică uşor de folosit, similară cu cea utilizată în cazul sistemului de operare Windows, care permite accesarea resurselor unei reţele de acest tip prin numai câteva butonări ale mouse-ului. O altă problemă de accesibilitate ar fi dată de faptul că în prezent există mai multe tipuri de arhitecturi utilizate în realizarea acestor reţele, fiind necesar un mecanism care să depăşească această barieră atunci când vine vorba de acordarea unui acces facil la resursele unui grid. Indiferent de structura pe care acesta o prezintă, g-Eclipse oferă o soluţie în acest sens, fiind conceput ca un echivalent al browsere-lor actuale pentru ceea ce ar putea deveni World Wide Grid.
Sursa Jurnalul National, Mihai Manole
vineri, 28 noiembrie 2008
Avem search
Avem functionalitate de search pe site. Si la noi chiar merge. Incercati si dati sugestii
joi, 27 noiembrie 2008
Web-ul semantic
Una dintre provocările de actualitate din domeniul tehnologiei care stă la baza motoarelor de căutare este tocmai clasificarea informaţiilor după criterii cât mai sugestive şi reprezentative, fie că e vorba de informaţii de tip text, conţinut video sau fotografii.
Un domeniu în care progresele în această direcţie sunt mai uşor de observat este cel universitar, în care multitudinea de resurse de tip eLearning (învăţământ electronic) a generat nevoia unei organizări eficiente a tuturor informaţiilor digitale. Astfel, mai multe universităţi au început să investească în sisteme de management al învăţământului (LMS-uri) pentru arhivare şi prezentarea resurselor online într-o manieră sistematică, potrivit serviciului ICT Results. În domeniul universitar, căutările clasice în aceste depozite digitale de informaţii, aşa cum se procedează în cazul Google de exemplu, au început să fie înlocuite de tehnici mai complexe, care ţin cont mai degrabă de semnificaţia informaţiilor decât de cuvintele în care sunt acestea redate.
ABORDĂRI
Una din abordările studiate în cadrul unui proiect european de cercetare numit Tehnologii Lingvistice pentru eLearning o reprezintă extragerea automată a unor cuvinte-cheie din documente. Prototipul unui astfel de instrument a fost conceput să funcţioneze şi pentru documente scrise în limba română, din domeniul calculatoarelor. O a doua abordare, mult mai sofisticată, permite studenţilor să caute informaţii în funcţie de anumite concepte, aşa-numita căutare semantică în care cuvintele-cheie şi definiţiile sunt ierarhizate în funcţie de sensul lor, în ceea ce se numesc ontologii. Una dintre principalele probleme ale acestei metode este însă dată de faptul că utilizatorilor le vine destul de greu să o adopte, după ce au folosit atât de mult timp căutări "clasice". De aceea, una din direcţiile de cercetare în cadrul acestui proiect este dată de adaptarea principiilor căutării semantice la interfeţe mult mai prietenoase, folosite de exemplu în cazul reţelelor online de socializare.
SearchWiki
Dincolo de domeniul universitar, motoarele de căutare se îmbunătăţesc pe zi ce trece, încercând să ofere utilizatorului o experienţă cât mai facilă de căutare. Un exemplu în acest sens îl reprezintă SearchWiki-ul celor de la Google, un instrument care permite utilizatorilor să îşi personalizeze şi să îşi eficientizeze interogările online. Un utilizator îşi poate sorta lista de rezultate întoarse de Google în funcţie de preferinţele sale, ordine care se va păstra la interogări ulterioare. De asemenea, dacă este logat într-un cont Google, un utilizator poate lăsa comentarii în dreptul a diferite rezultate, care vor putea fi accesate şi de către alţi utilizatori, într-un fel de evaluare publică a diferitelor site-uri.
Sursa Jurnalul National, Mihai Manole
Un domeniu în care progresele în această direcţie sunt mai uşor de observat este cel universitar, în care multitudinea de resurse de tip eLearning (învăţământ electronic) a generat nevoia unei organizări eficiente a tuturor informaţiilor digitale. Astfel, mai multe universităţi au început să investească în sisteme de management al învăţământului (LMS-uri) pentru arhivare şi prezentarea resurselor online într-o manieră sistematică, potrivit serviciului ICT Results. În domeniul universitar, căutările clasice în aceste depozite digitale de informaţii, aşa cum se procedează în cazul Google de exemplu, au început să fie înlocuite de tehnici mai complexe, care ţin cont mai degrabă de semnificaţia informaţiilor decât de cuvintele în care sunt acestea redate.
ABORDĂRI
Una din abordările studiate în cadrul unui proiect european de cercetare numit Tehnologii Lingvistice pentru eLearning o reprezintă extragerea automată a unor cuvinte-cheie din documente. Prototipul unui astfel de instrument a fost conceput să funcţioneze şi pentru documente scrise în limba română, din domeniul calculatoarelor. O a doua abordare, mult mai sofisticată, permite studenţilor să caute informaţii în funcţie de anumite concepte, aşa-numita căutare semantică în care cuvintele-cheie şi definiţiile sunt ierarhizate în funcţie de sensul lor, în ceea ce se numesc ontologii. Una dintre principalele probleme ale acestei metode este însă dată de faptul că utilizatorilor le vine destul de greu să o adopte, după ce au folosit atât de mult timp căutări "clasice". De aceea, una din direcţiile de cercetare în cadrul acestui proiect este dată de adaptarea principiilor căutării semantice la interfeţe mult mai prietenoase, folosite de exemplu în cazul reţelelor online de socializare.
SearchWiki
Dincolo de domeniul universitar, motoarele de căutare se îmbunătăţesc pe zi ce trece, încercând să ofere utilizatorului o experienţă cât mai facilă de căutare. Un exemplu în acest sens îl reprezintă SearchWiki-ul celor de la Google, un instrument care permite utilizatorilor să îşi personalizeze şi să îşi eficientizeze interogările online. Un utilizator îşi poate sorta lista de rezultate întoarse de Google în funcţie de preferinţele sale, ordine care se va păstra la interogări ulterioare. De asemenea, dacă este logat într-un cont Google, un utilizator poate lăsa comentarii în dreptul a diferite rezultate, care vor putea fi accesate şi de către alţi utilizatori, într-un fel de evaluare publică a diferitelor site-uri.
Sursa Jurnalul National, Mihai Manole
In curand , tema javascript&co
In asteptarea postarii temei 3 am cautat niste scripturi simple javascript. Un exemplu in acest sens, cu un ceas digital, il gasiti aici
miercuri, 26 noiembrie 2008
Computere la superlativ
Computerele cuantice folosesc o metodă nouă de codificare a informaţiei faţă de calculatoarele clasice, a căror unitate de bază în această privinţă este bitul, ce poate lua două valori: 0, respectiv 1. În prezent, tot ce realizăm în fiecare zi cu un calculator este reprezentat sub forma unor secvenţe de 1 şi 0. Calculatoarele cuantice schimbă această paradigmă, în sensul în care informaţia este reprezentată, în acest caz, de biţi ce pot lua simultan ambele valori, cunoscuţi sub numele de biţi cuantici. Această situaţie poartă denumirea de superpoziţie. Optimizarea permite calculatoarelor cuantice să rezolve probleme care sunt aproape imposibile pentru echipamentele clasice.
CUM FUNCŢIONEAZĂ?
Bitul cuantic, qubitul, se bazează pe o proprietate a electronilor, numită spin, care cunoaşte două stări. Viteza de detectare a acestor stări reprezintă premisa tehnologiei cuantice. O echipă de cercetători britanici şi americani a făcut un pas important spre aducerea calculatorului cuantic din stadiul teore-tic mai aproape de practică. Aceştia au reuşit să “citească” starea electronilor, potenţiali qubiţi, folosindu-se de un câmp magnetic puternic, temperaturi foarte scăzute şi curent electric. Perspectiva conceperii unui prototip stabil de calculator cuantic este însă destul de îndepărtată. Cercetătorii speră să aibă un astfel de model în laborator abia în următorii 15-20 de ani.
PERFORMANŢĂ
Pentru moment, cele mai performante computere de pe planetă concurează pentru un loc cât mai bun în Top 500, un clasament de referinţă în acest domeniu. Săptămâna aceasta a avut loc o nouă actualizare a listei, pe primul loc continuând să se situeze Roadrunner, sistemul IBM instalat în Departamentul pentru Energie al Laboratorului National Los Alamos, SUA. Roadrunner este capabil să realizeze cvadrilion (1.000 de trilioane) de operaţii pe secundă.
ATOM ŞI MOLECULE
Unul dintre cele mai noi concepte in domeniul supercomputerelor vine din partea Silicon Graphics (SGI), companie care a pus la punct un model ce funcţionează pe baza procesoarelor Intel Atom. Ineditul situaţiei vine din faptul că acest tip de procesoare este destinat în principal dispozitivelor ultramobile, netbook-urilor de 9-10 inci, nicidecum unor sisteme atât de sofisticate precum supercomputerele.
Prototipul prezentat de SGI, botezat sugestiv Molecule, foloseşte 10.000 de procesoare Atom, oferind o putere echivalentă cu cea a 750 de PC-uri de ultimă generaţie, la un consum energetic înjumătăţit. Şi pentru ca această noţiune, de supercomputer, să nu mai pară rezervată laboratoarelor de cercetare, Nvidia a lansat un model din această categorie, care are un preţ similar cu cel al unei staţii PC clasice din această categorie, asta însemnând circa 10.000 de dolari. Performanţele oferite sunt însă de 250 de ori mai bune. Tesla Personal Supercomputer are o arhitectură bazată pe procesorul grafic C1060, fiind promovat mai degrabă ca un design de referinţă decât ca un produs de serie.
Sursa Jurnalul National, Mihai Manole
CUM FUNCŢIONEAZĂ?
Bitul cuantic, qubitul, se bazează pe o proprietate a electronilor, numită spin, care cunoaşte două stări. Viteza de detectare a acestor stări reprezintă premisa tehnologiei cuantice. O echipă de cercetători britanici şi americani a făcut un pas important spre aducerea calculatorului cuantic din stadiul teore-tic mai aproape de practică. Aceştia au reuşit să “citească” starea electronilor, potenţiali qubiţi, folosindu-se de un câmp magnetic puternic, temperaturi foarte scăzute şi curent electric. Perspectiva conceperii unui prototip stabil de calculator cuantic este însă destul de îndepărtată. Cercetătorii speră să aibă un astfel de model în laborator abia în următorii 15-20 de ani.
PERFORMANŢĂ
Pentru moment, cele mai performante computere de pe planetă concurează pentru un loc cât mai bun în Top 500, un clasament de referinţă în acest domeniu. Săptămâna aceasta a avut loc o nouă actualizare a listei, pe primul loc continuând să se situeze Roadrunner, sistemul IBM instalat în Departamentul pentru Energie al Laboratorului National Los Alamos, SUA. Roadrunner este capabil să realizeze cvadrilion (1.000 de trilioane) de operaţii pe secundă.
ATOM ŞI MOLECULE
Unul dintre cele mai noi concepte in domeniul supercomputerelor vine din partea Silicon Graphics (SGI), companie care a pus la punct un model ce funcţionează pe baza procesoarelor Intel Atom. Ineditul situaţiei vine din faptul că acest tip de procesoare este destinat în principal dispozitivelor ultramobile, netbook-urilor de 9-10 inci, nicidecum unor sisteme atât de sofisticate precum supercomputerele.
Prototipul prezentat de SGI, botezat sugestiv Molecule, foloseşte 10.000 de procesoare Atom, oferind o putere echivalentă cu cea a 750 de PC-uri de ultimă generaţie, la un consum energetic înjumătăţit. Şi pentru ca această noţiune, de supercomputer, să nu mai pară rezervată laboratoarelor de cercetare, Nvidia a lansat un model din această categorie, care are un preţ similar cu cel al unei staţii PC clasice din această categorie, asta însemnând circa 10.000 de dolari. Performanţele oferite sunt însă de 250 de ori mai bune. Tesla Personal Supercomputer are o arhitectură bazată pe procesorul grafic C1060, fiind promovat mai degrabă ca un design de referinţă decât ca un produs de serie.
Sursa Jurnalul National, Mihai Manole
luni, 24 noiembrie 2008
Avem Google-ul nostru
Google a lansat de curand un serviciu nou, aflat inca in stadiul Beta: Google Custom Search. Acesta permite utilizatorilor sa isi faca propriul motor de cautare, mai precis sa isi personalizeze google-ul si sa si-l integreze in site. Pentru inceput noi ne-am integrat un astfel de motor de cautare pe blog, fara sa ne "jucam" prea mult cu toate optiunile puse la dispozitie. Ideea e (una dintre ele) ca, in asteptarea googlebot-ului pentru a-ti indexa site-ul si/sau sitemap-ul, poti sa ai satisfactia ca ti-l indexeaza on demand googlebot-ul tau personalizat.
Abonați-vă la:
Postări (Atom)


